CRDT 是一类数据结构,允许多个副本各自本地修改,同步时自动合并成同一结果,不需要事先协调。它解决的是离线编辑与弱网同步:用户断网也能写,重连后不弹冲突对话框。代价藏在元数据里——删除的内容不会真正消失,只会变成墓碑。
先看两种复制模型
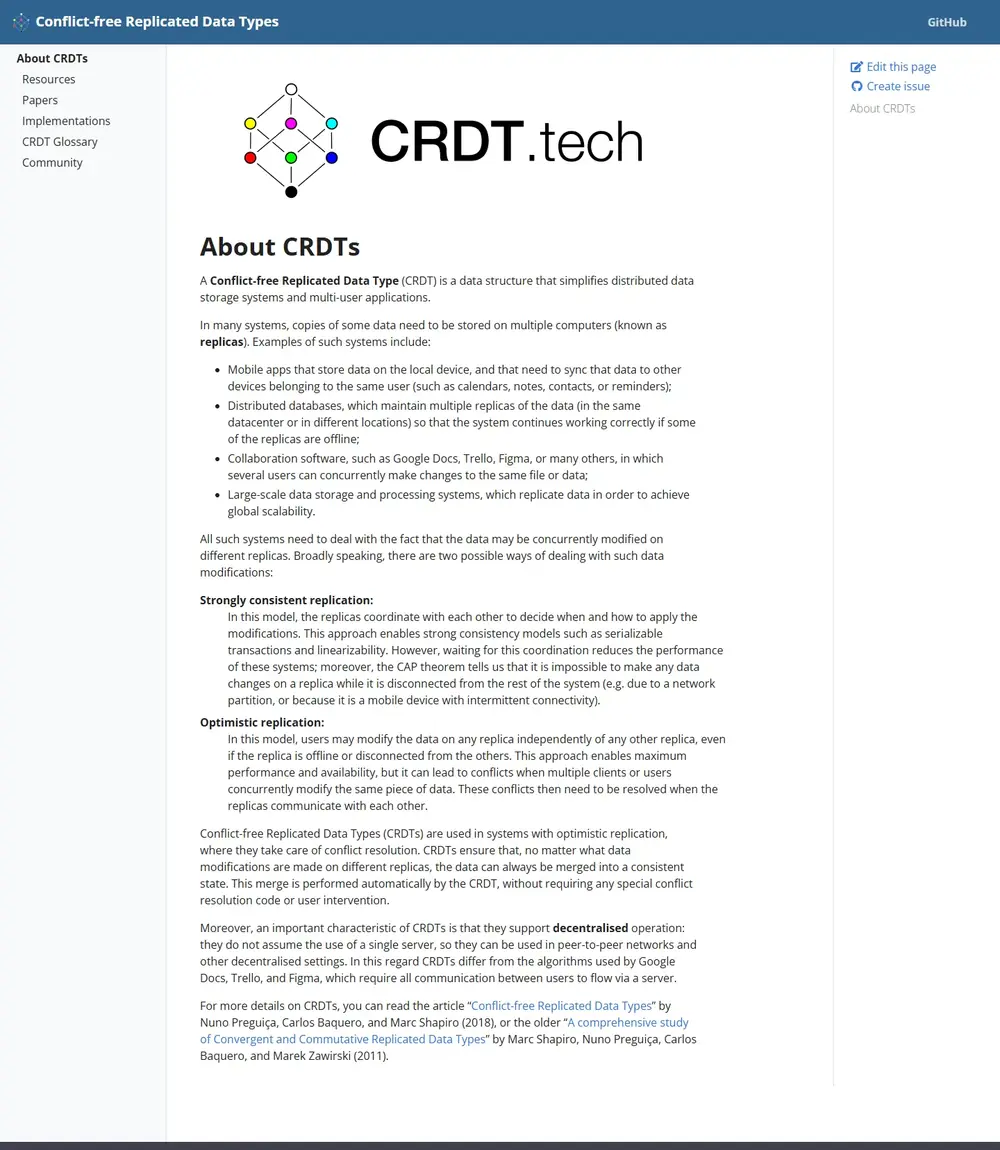
按crdt.tech 的划分,多副本系统处理并发修改有两条路。强一致复制让副本先协调再落盘,能给出可串行化与线性一致,但断网时无法写入。乐观复制允许各副本先改、后合并,可用性高,代价是合并时要消解冲突。
CRDT 属于后一条路。它把冲突消解提前做进数据结构里,合并函数由类型本身定义,不依赖应用层写冲突处理代码,也不假设存在中心服务器。
Shapiro 等人在 2011 年的技术报告里,把这两类系统整理成了一套分类。基于状态的 CRDT(CvRDT,也称收敛复制数据类型)同步的是完整状态。收到远端状态后调用 merge,得到两者的上确界。这类实现的网络假设宽松:丢包、重发、乱序都能容忍,代价是每次同步的报文可能很大。Delta-state 变体做了折中,只传播最近一次增量,而不是整个状态。
基于操作的 CRDT(CmRDT,也称可交换复制数据类型)同步的是操作本身,比如“在 x 之后插入 a”。它要求传输层保证可靠且因果有序的投递,操作在任意副本上以任意顺序应用,结果相同。带宽省下来了,对网络与中间件的要求抬上去了。
| 维度 | CvRDT(基于状态) | CmRDT(基于操作) |
|---|---|---|
| 同步内容 | 完整状态或增量状态 | 单个操作 |
| 对网络的要求 | 最终送达即可,容忍重复与乱序 | 可靠、因果有序、不重复投递 |
| 传输开销 | 随状态大小增长 | 随操作数量增长 |
| 离线合并 | 天然支持,重连后交换状态 | 需要缓存操作日志,按因果序重放 |
| 典型代表 | G-Counter、2P-Set | RGA、YATA 的同步层 |
常见数据类型与它们的合并规则
计数器是比较好上手的例子。G-Counter 给每个副本留一个槽位,本地只增自己的槽位,合并时逐位取较大值,读数时把各位相加。因为取较大值满足交换、结合、幂等,合并顺序不影响结果。
PN-Counter 用两个 G-Counter 相减,一个记增量、一个记减量,于是支持递减,代价是元数据翻倍。它不能保证计数不为负,因为并发扣减合并后可能越过零。
寄存器有两种常见形态。LWW-Register 保留时间戳较大的写入,适合用户资料这类“后写覆盖前写”的字段;时间戳相同就再比一次节点标识,保证各副本选出同一个值。MV-Register 反过来,保留并发写入的多个值,交给应用或用户裁决,适合需要人工确认的场景。
集合类里,2P-Set 只允许增删各一次,用“存在集加墓碑集”实现删除优先;OR-Set 给每个元素打上不重复的标签,删除只移除自己见过的标签,因此支持反复增删,代价是元数据随操作增长。
序列最复杂。RGA(Replicated Growable Array)由 Roh 等人在 2011 年的论文里提出,做法是给每个字符一个由时间戳与节点标识组成的全局标识,插入时声明“插在某个标识之后”,而不是“插在第几位”。两个并发插入争同一位置时,按标识的全序排定先后,各副本算出同一个顺序。
| 结构 | 语义 | 合并方式 | 局限 |
|---|---|---|---|
| G-Counter | 只增计数 | 各槽位取较大值后求和 | 不能递减 |
| PN-Counter | 可增可减计数 | 两个 G-Counter 相减 | 元数据翻倍,不能保证非负 |
| LWW-Register | 单值覆盖 | 时间戳大者胜,同戳比节点标识 | 依赖时钟质量 |
| OR-Set | 可反复增删的集合 | 按标签合并,删除只删自己见过的标签 | 元数据随操作增长 |
| RGA 序列 | 有序文本 | 按前驱标识定位,按标识全序定序 | 删除留墓碑,结构持续增长 |
偏序与合并函数为什么能收敛
收敛不是靠概率,是靠代数结构。CvRDT 的全部可能状态构成一个 join-semilattice:任意两个状态都能求出一个上确界,而且这个上确界满足交换律、结合律、幂等律。
三条性质各管一件事。交换律保证“先收谁的更新”不影响结果;结合律保证“分批合并”等价于“一次合并”;幂等保证重复收到同一份状态不会把结果推得更远。三条凑齐,任意乱序、任意重传,最终都落在同一个状态上。
还有一条容易被忽略的前提:更新函数必须单调。本地状态只能沿偏序向上走,不能回退。这条限制解释了 CRDT 的边界——它擅长表达“信息只会累积”的结构,比如集合、计数、追加日志。
这套性质换来的是强最终一致性(SEC):只要两个副本收到了同一组更新,它们就处于相同状态,与是否还有新写入无关。相比之下,普通最终一致只承诺“没有新写入时会一致”,不承诺一致到哪个状态。
做不到的事情也要说清。余额不能为负、用户名不能重名、库存不能超卖,这类“必须拒绝”的约束不是可合并结构。并发扣减各自合法,合并后可能越界。要守住这类不变量,只能回到共识、锁或事后对账。
与 OT 的分工和代价
OT(操作变换)走的是另一条路。它让所有操作先经过中心服务器定序,再用变换函数把并发操作改写成可应用的形式。Google Docs 这类产品长期使用这套方案,crdt.tech 也指出这类系统的通信需要经由服务器中转。
两者的分工可以从三个角度看。
- 拓扑:OT 依赖中心节点做定序,CRDT 可以在点对点网络里合并,服务器只是可选的汇聚点。
- 正确性:OT 的正确性依赖变换函数的性质证明,组合情形多,实现容易出错;CRDT 把正确性压在合并函数的代数性质上,证明对象更小。
- 开销:OT 的报文小、服务端状态轻,但断网期间难以继续编辑;CRDT 报文可以离线累积,代价是每个元素都要带标识与因果信息。
工程上还有第三种选择:用 CRDT 做数据模型,用中心服务器做持久化与广播。Yjs 的定位就是这样,核心库不假设网络形态,同步交给 provider。
离线合并与墓碑增长
删除在 CRDT 里是标记,不是抹除。一个字符被删掉后,它的标识与位置要保留下来,因为别的副本可能正引用它作为插入锚点。这类残留结构叫墓碑(tombstone)。
Yjs 的实现可以看清这条链路。每个插入生成一个 Item,标识是客户端编号与逻辑时钟组成的二元组;删除时内容被替换为不携带内容的删除项,位置信息保留。状态向量记录“每个客户端下一个期望的时钟值”,用于算出差量、只传缺失部分。
垃圾回收只能回收内容,不能回收结构,而且要等到确认没有副本还会引用它。据 nebelwolfi 对 Moment.dev 停止使用 Yjs 的复盘分析,长期存活的文档里,编码后的状态可能达到可见内容的 10 到 50 倍;持续编辑半年的文档,服务端内存占用会明显偏离文本体积。同一篇文章引用的 crdt-benchmarks 数据里,约 26 万次操作、约 10 万字节可见文本的会话,Yjs 编码后约 130 KB,Automerge 2.x 约 150 KB。
缓解办法有几条,都是工程取舍。
- 分段:按章节或按时间切文档,让单个 CRDT 文档的编辑历史可控。
- 快照:定期生成快照并归档旧更新,读取时从快照加增量恢复。
- 压缩:Automerge 用列式压缩存储,Yjs 用合并相邻结构体的方式压缩编码,都能把体积压下来,但不改变增长趋势。
- 控制编辑粒度:把大段粘贴拆成有限次操作,避免单次插入生成过多结构体。
Automerge 的取舍方向不同。它保留完整变更历史,支持分支与回看,用压缩的列式存储在磁盘和内存里容纳上百万次变更,定位接近“数据的版本控制”。要历史还是要轻量,是选型时先要回答的问题。
五个常见误区
误区一:CRDT 不需要任何协调。合并不需要协调,但传输、身份分配、持久化、权限校验一样都要。两个会话复用了同一个客户端标识,文档就可能损坏,这是实现层面的硬约束。
误区二:收敛就等于结果正确。收敛只保证各副本一致,不保证一致到业务上合理的值。LWW 会安静地丢掉一方的写入,计数器会越过业务上限。语义层的冲突仍要应用自己处理。
误区三:LWW 是“谁最后点谁赢”。实际执行的是确定性规则:比逻辑时间戳,相同再比节点标识。墙钟时间不参与定序,手快不代表会赢。
误区四:用了 CRDT 就不需要服务器。多数产品仍要服务器做中继、存储与鉴权。CRDT 去掉的是“定序中心”,不是后端本身。
误区五:墓碑总会被回收干净。客户端全部离线后重载,回收可能生效;长期在线的服务端很难等到“没有副本还会引用”这个条件,垃圾回收基本不触发。
选型可以先问三句:数据是否只需要累积、冲突能否用确定性规则裁决、文档寿命有多长。三个答案都偏向累积、可裁决、短周期,CRDT 的收益就明显。要守住强不变量,或者只需要在线协作,中心化定序仍是更省事的路。MIT 6.5840 分布式系统那套课程里的复制与一致性章节,可以做理论补课;网络层怎么扛住乱序与重传,可对照QUIC 与 HTTP/3 工作原理里的连接与重传机制。
相关地址
以下为文中涉及的论文、项目与文档入口,算法细节与版本说明以这些页面为准。
- CRDT 资料与实现列表:https://crdt.tech/
- Shapiro 等,《A comprehensive study of Convergent and Commutative Replicated Data Types》(2011):https://hal.inria.fr/inria-00555588/document
- Preguiça、Baquero、Shapiro,《Conflict-free Replicated Data Types》(2018):https://arxiv.org/pdf/1805.06358.pdf
- Yjs 文档:https://docs.yjs.dev/
- Yjs(GitHub 仓库):https://github.com/yjs/yjs
- Automerge(官网):https://automerge.org/
- Automerge(Rust 文档):https://docs.rs/automerge/latest/automerge/
© 版权声明
文章版权归作者所有,转载需注明出处。未声明原创的皆为网络收集,如有侵权请邮箱lishiwenhuagx@sina.com联系下架处理。


