eBPF 是把一段受限字节码交给内核、由内核在指定钩子上执行的机制。它不修改内核源码,也不加载内核模块,程序运行前先过验证器,再由 JIT 编译成机器指令。这篇文章讲清四件事:它凭什么能进内核、五类常用程序挂在哪里、验证器拦什么、数据怎么回到用户态。
eBPF 为什么能进内核:加载、验证与 JIT
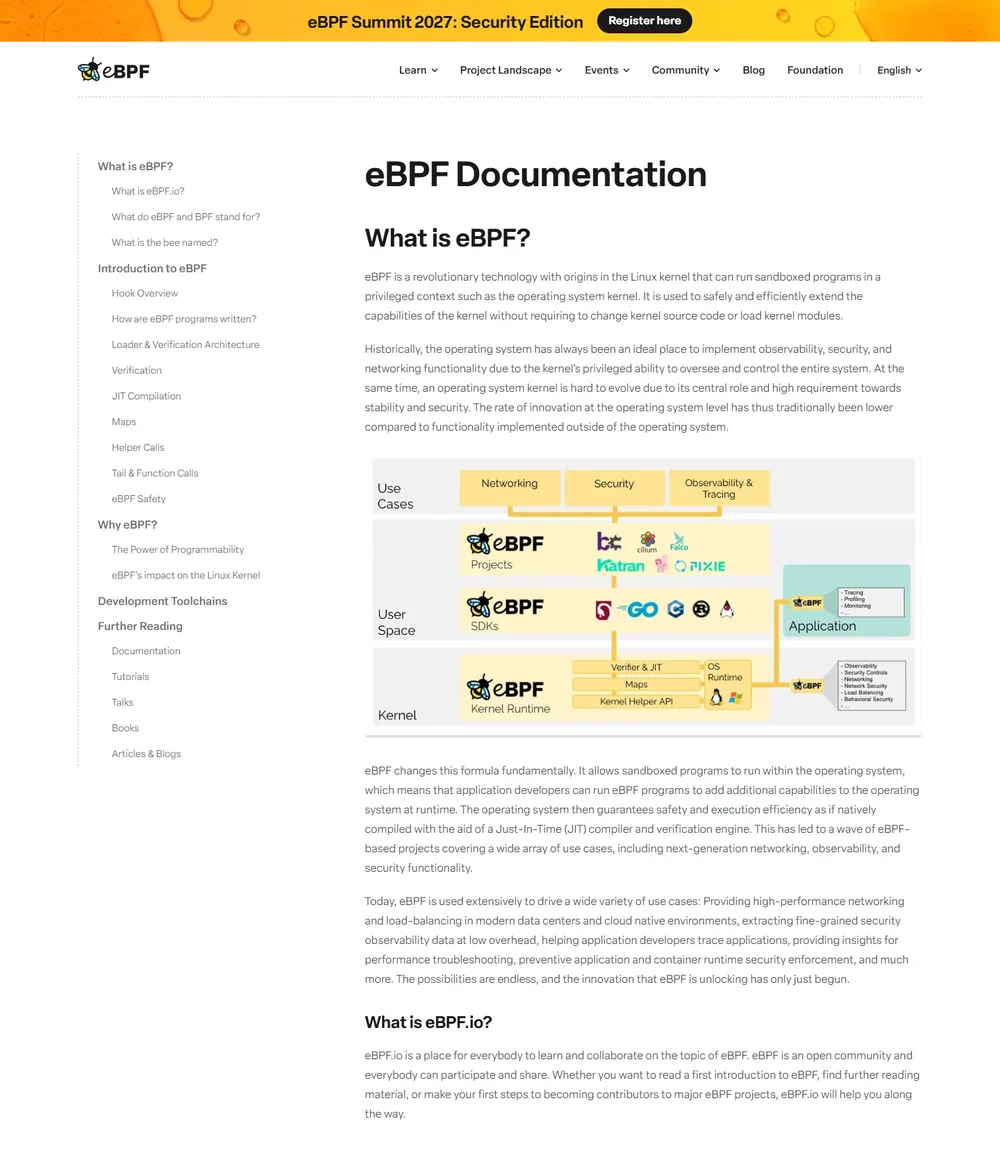
想在 Linux 里加功能,历史上只有两条路:改内核源码,等它进发行版;或者写内核模块。前者周期以年计,后者要跟着每个内核版本反复修补,模块本身也没有安全边界。eBPF 官方介绍把这层困境说得很直白:内核位置关键、稳定性要求高,因此演进速度长期慢于内核之外的功能。
eBPF 提供第三条路。开发者用 C 写逻辑,LLVM 编译成字节码,经由 bpf() 系统调用交给内核。内核先验证,再交给 JIT 翻译成目标架构的指令,最后挂到请求的钩子上。全程不需要重启,也不需要重新编译内核。
权限是前提。除非内核显式开启非特权 eBPF,只有持有相应能力的进程才能加载程序。验证器和 JIT 分工明确:前者判断程序会不会把系统搞坏,后者只负责让它跑得快。
eBPF 的五种程序类型与挂载点
程序类型不是标签。它决定了程序能拿到什么上下文、能调用哪些 helper、能不能改写数据包。下面五类覆盖了观测与网络的大部分日常场景。
| 类型与 section 名 | 挂载位置 | 触发时机 | 常见用途 |
|---|---|---|---|
| kprobe / uprobe | 内核或用户态函数入口,可加偏移 | 执行到该函数时 | 抓参数、查调用链 |
| tracepoint | 内核预置的静态埋点 | 埋点被触发时 | 长期观测,不易被改名影响 |
| XDP | 网卡驱动的收包环 | 包刚被驱动取到、尚未生成 skb | 丢弃、重定向、DDoS 过滤 |
| tc | 接收与发送主路径上的两个函数 | GRO 之后、协议处理之前(入向) | 限速、NAT、策略路由 |
| cgroup_skb | 挂到 cgroup,覆盖组内进程的 socket | 组内进程收发包时 | 按容器或用户组计量与过滤 |
kprobe 与 uprobe 是动态探针,名字来自内核符号,函数一改名就得跟着改。tracepoint 是静态埋点,名字相对稳定,排查长期问题更省心。它们的 section 名分别写作 kprobe/、uprobe/、tracepoint/,eBPF 文档的程序类型索引把对应关系列全了。
XDP 跑在驱动收包环上,此时包还没封装成 skb,也还没进 GRO,因此只能处理入向流量,换来的是更靠前的拦截位置。tc 挂在接收与发送主路径上,入向出向都能管,代价是位置更靠后,且需要走通用网络层。Cilium 的程序类型文档对这两个挂载点有逐条说明。
cgroup 类程序依附 cgroup 这个记账单位,覆盖组内进程的 socket,返回 0 表示丢弃、1 表示放行,只能过滤不能改包。tc 管的是队列与转发,和传输层拥塞控制不是一回事,站内CUBIC 与 BBR 怎么选讲的是后者,对照读能少混一次。cgroup 这一层的另一面是资源记账,站内cgroup v2 内存控制写的是同层级的内存账。
验证器到底拦什么
验证器从入口开始走遍所有可能路径,逐条模拟指令,记录每个寄存器和栈槽的类型与取值范围。它不接受“大概安全”,只接受“可以证明安全”。
循环不是禁区,但有条件。程序可以有界循环,前提是验证器能确认退出条件一定成立,证明不了就拒载。内核验证器文档把这条归入“程序必须运行到结束”。
指针算术管得很紧。两个指针相加会退化成普通标量,因为结果不再是合法地址。早期只认“指针加常数”,现在也认“指针加有界寄存器”,边界仍要能被跟踪。栈读取同样有先后:没写过的槽不能读,越界会报 invalid stack off。
栈容量常被记错。解释器与传统限制是每帧 512 字节;在 x86-64 与 arm64 上,若 JIT 声明支持大栈,整条调用链合计可用 2 KiB。内核 BPF 设计问答正是按这个条件分开写的,只说“512 字节”并不完整。
复杂度也有硬线。非特权程序的指令数上限是 4096,验证过程可探索的指令数上限是 100 万。程序越复杂,越容易撞上分析预算,而不是撞上功能限制。
还要分清验证器的定位。按 eBPF 官方说法,它是安全工具,检查程序会不会危害系统,而不是审计工具,不负责判断程序在做什么。另有 helper 白名单:能调的函数集合按程序类型定义,网络类程序拿不到读取任意内存的 helper,追踪类才行。
数据怎么出来:map 与 ring buffer
eBPF 程序只能返回一个数值,要留状态、传事件,都得经过 map。map 是内核里的键值结构,程序侧用 bpf_map_lookup_elem、bpf_map_update_elem、bpf_map_delete_elem 访问,用户态走 bpf() 的 BPF_MAP_LOOKUP_ELEM 等命令。
两边必须对键值布局有共同理解,否则读到的是错位的字节。两侧用 C 写并共享头文件比较省事,跨语言只能靠字节级约定。eBPF 文档的 map 章节把这条限制写在开头。
类型按数据形状选:hash 适合按 pid 或五元组查表,array 适合固定槽位计数,per-CPU 变体避免多核争用,LRU 用于有上限的缓存。每个程序能关联的 map 上限是 64 个,这个数字比想象中容易碰到。
ring buffer 是事件通道的常见选择,5.8 引入。它只有一个环,不像 perf event array 按 CPU 分片,跨 CPU 的事件顺序能保住。大小必须是 2 的幂,也必须是页大小的整数倍。
用户态把消费页 mmap 进来,用 epoll 等新数据;内核侧用 reserve、submit、discard 三件套写入,reserve 拿到的空间不计入栈,写大样本不必抠栈。ring buffer 文档也提醒,高频小事件仍要付写入与对齐的开销。这套共享环与 io_uring 的提交环、完成环有相似处,站内io_uring 两个环的拆解可以对照着看。
可移植性:BTF 与 CO-RE
直接按固定偏移读内核结构体,换个内核就可能读错字段。字段会增删、会改序,偏移跟着变,为每个内核版本预编译一份程序并不现实。
BTF 把类型信息编进内核镜像。检查办法很直接:/sys/kernel/btf/vmlinux 存在,就说明内核带了 BTF。没有的话需要 CONFIG_DEBUG_INFO_BTF=y,并用 pahole 1.16 以上从 DWARF 转换。libbpf 仓库列出了自带 BTF 的发行版,包括 Fedora 31 以后、RHEL 8.2 以后、Ubuntu 20.10 与 Debian 11。
CO-RE 的思路是延迟重定位。编译时记录“要读哪个字段”,加载时由 libbpf 用本地类型去匹配目标内核的 BTF,把偏移改成实际值。vmlinux.h 由 bpftool 从 BTF 生成,省掉 include 内核头文件;字段加上 preserve_access_index 属性后,直接解引用也能参与重定位。
一条限制常被忽略:只有偏移会重定位,字段大小不会,所以按结构体整体拷贝并不可靠。这份 CO-RE 参考给了兼容手法:用 bpf_core_field_exists 做存在性检查,不匹配的分支变成死代码,由验证器消除。编译侧需要 Clang/LLVM 10 以上。
五个常见误区
- 当成内核模块。模块是直接编进内核地址空间的代码,出问题就是内核崩。eBPF 程序要先过验证器,不能直接读写任意内存,失效方式完全不同。
- 以为能任意改内核内存。内核问答的回答是 NO:追踪类程序能用 probe_read 读任意内存,网络类连这个 helper 都没有,谁都不能直接读写任意地址。
- 以为零开销。JIT 之后代码接近原生,但每个包、每个事件仍要执行指令。helper 调用、map 查找、事件拷贝都要花时间,尾调用还有 32 次的上限。
- 忽略 helper 白名单。helper 与 kfunc 按程序类型授权。写了当前类型不支持的调用,加载阶段就会失败,而不是等运行时才发现。
- 混淆 XDP 与 tc 的收包位置。XDP 在驱动收包环、skb 生成之前,只处理入向;tc 在协议栈的接收与发送函数里,双向可用。限速逻辑放错层,效果会完全不同。
上手不必从写 C 开始。装一个 bpftrace,用一行脚本挂到 tracepoint 上看延迟分布,先建立“钩子在哪、能拿到什么”的直觉。要进生产,再补 libbpf 与 CO-RE 的工程细节,同时确认运行环境有 root 或相应能力,以及内核是否带 BTF。
相关地址
以下为文中项目的官方入口,版本、字段与默认值以这些页面为准。
- eBPF 官方介绍(ebpf.io):https://ebpf.io/what-is-ebpf/
- eBPF 文档程序类型索引(eBPF Docs):https://docs.ebpf.io/linux/program-type/
- Linux 内核 BPF 验证器文档(kernel.org):https://docs.kernel.org/bpf/verifier.html
- Linux 内核 BPF 设计问答(kernel.org):https://docs.kernel.org/bpf/bpf_design_QA.html
- Cilium BPF 程序类型参考(Cilium 文档):https://docs.cilium.io/en/stable/reference-guides/bpf/progtypes/
- libbpf(GitHub 仓库):https://github.com/libbpf/libbpf
- bpftrace(GitHub 仓库):https://github.com/bpftrace/bpftrace
© 版权声明
文章版权归作者所有,转载需注明出处。未声明原创的皆为网络收集,如有侵权请邮箱lishiwenhuagx@sina.com联系下架处理。
相关文章