Hugging Face 的 LLM Course 是一门免费的大模型课程,从 Transformer 原理一路讲到微调与推理模型,每一节都配了可以在浏览器里跑的 Colab。它不推公式,重心是把 transformers、datasets、tokenizers 这几个库真正用起来,适合会写 Python、想动手做点东西的人。
课程结构:0 到 12 章各教什么
官网目录一共十三个编号,从 0 到 12。0 是环境准备,1 到 12 是正文。官方把正文分成四段:1 到 4 章讲 Transformers 的基本用法,5 到 8 章讲 Datasets、Tokenizers 与经典 NLP 任务,第 9 章做演示页面,10 到 12 章进入高级主题。
| 章节 | 主题 | 学完能做什么 |
|---|---|---|
| 0 | 环境搭建:Colab 或本地虚拟环境 | 装好依赖,跑通一段推理代码 |
| 1 | Transformer 模型:它能做什么、怎么工作、架构与局限 | 说清注意力与编码解码的分工,识别模型偏见 |
| 2 | 使用 Transformers:pipeline 背后、模型、分词器、多序列处理 | 用 AutoModel 与 AutoTokenizer 手写推理流程 |
| 3 | 微调预训练模型:数据处理、Trainer、完整训练循环 | 把 BERT 类模型微调到一个分类任务上 |
| 4 | 共享模型与分词器:Hub 上传与 model card | 把自己的权重推上 Hub 并写清说明 |
| 5 | Datasets 库:切片、大数据、自建数据集、FAISS 语义检索 | 处理本地数据并做向量检索 |
| 6 | Tokenizers 库:BPE、WordPiece、Unigram 与逐步搭建 | 自己训练一个分词器并解释它的切分 |
| 7 | 经典任务:词元分类、翻译、摘要、问答、从零训练因果语言模型 | 覆盖大多数文本任务的微调套路 |
| 8 | 如何求助:读报错、论坛提问、调试训练管线 | 把「跑不通」变成可复现的问题描述 |
| 9 | 用 Gradio 构建并分享演示 | 给模型套一个可分享的网页界面 |
| 10 | 高质量数据集:用 Argilla 做标注 | 组织人工标注并回收可用数据集 |
| 11 | 微调大模型:chat template、SFTTrainer、LoRA、评估 | 在小显存上完成一次指令微调 |
| 12 | 构建推理模型:GRPO、DeepSeek R1 的复现思路、TRL 与 Unsloth | 理解强化学习训练推理模型的最小流程 |
这里要纠正一个常见误解:目录里没有独立的「智能体」章节。智能体内容在另一门 Agents Course,单独开课,进度与证书也另算。写作时若把两者混在一起,章节数就对不上了。
环境与 Notebook:Colab 起步,Windows 绕行
开篇部分写得很直白:课程不覆盖 Windows。用 Windows 的话,跟着 Colab 走;Linux 或 macOS 可以二选一,本地虚拟环境或 Colab 都行。原因不难猜,依赖、CUDA 与编译工具链的差异太大,逐个排障会拖垮课程节奏。
装库只用一条命令:pip install transformers[sentencepiece]。不带方括号的那条只装轻量版,缺少机器学习框架与分词器的底层依赖,跑到后面会连环报错。
每节页面都带 Colab 入口,notebook 源码统一放在 huggingface/notebooks 仓库。想离线跑,可以把仓库克隆下来,按章节顺序打开。建议一开始就用 Colab 跑通前三章,再决定要不要把环境搬回本地,先证明代码没问题,再怀疑环境。
课程几乎每节都要登录 Hugging Face 账号,章节测验也在登录态下提交。注册免费,这一步没法跳过。
前置知识与每章耗时
官方给出的门槛有三条:需要较好的 Python 基础;建议先上过一门入门深度学习课,比如 fast.ai 的 Practical Deep Learning for Coders,或者 DeepLearning.AI 的课程;不要求事先会 PyTorch 或 TensorFlow,但熟悉其中之一会轻松不少。
把这三条翻译成能自测的标准:能读懂类和函数、会用 pip 与虚拟环境;知道张量与梯度下降在做什么;看到一段训练脚本,能指出数据、模型、损失、优化器分别在哪。第 3、11、12 章要改训练循环与超参,只会在 notebook 里按 Shift+Enter 的人会卡住。
时间上,官方课程页按每章一周、六到八小时估算,第三方盘点复述的数字一致。十二个正文章节乘下来约七十到一百小时,加上第 11、12 章的实验等待,按每周投入六到八小时算,三个月左右能走完一遍。这只是通读,做完练习还要再加。
认证与测验:目前到哪一步
从第 2 章到第 11 章,每章末尾都有一个小测,题量不大,答完当场给反馈。第 1 章最后一节的标题直接写着「Certification exam」,需要登录账号后在嵌入页面里作答。
但整门课的统一证书目前没有明确入口。课程 FAQ 至今仍写「暂不提供本课程的认证」,论坛上 2026 年 3 月还有人问怎么拿结课证书,回答是整门课没有统一证书,只有章节级的测验页面。官方自己的文案与页面状态并不完全同步,读的时候要以你打开的那一页为准。
如果证书对你很重要,需要区分两种情况:章节测验是知识点检查,答完不产生可下载凭证;能下载的完成证书在 Agents Course 那条线上,规则是完成单元作业加最终挑战。两门课的证书体系不通用。
和 fast.ai、CS224N 的分工
| 课程 | 入口门槛 | 重心 | 产出 |
|---|---|---|---|
| Hugging Face LLM Course | Python 熟练,建议先修一门深度学习入门课 | 库的用法与工程流程 | 能微调、能部署演示、能上 Hub |
| fast.ai 实践课 | 一年编程经验,高中数学 | 先跑通再讲原理,覆盖视觉与表格 | 九讲、每讲约 90 分钟,能独立训练模型 |
| Stanford CS224N | Python、微积分与线代、概率、机器学习基础 | NLP 的模型原理与论文脉络 | 作业加占 49% 的期末项目 |
三门课解决的不是同一件事。fast.ai 用九讲把人从零带到能训练模型,节奏快、覆盖广,NLP 只占其中一段;CS224N 是学期制课程,推导与论文阅读占比高,作业逐年更换,2024 版全套视频在 YouTube 公开;Hugging Face 这门课夹在中间,理论讲到够用为止,剩下时间都在调库。
选法可以按目标倒推:想尽快把模型接进项目,直接上这门;想把原理补齐再回来看库,先刷 CS224N 的前半段;完全没有深度学习经验,先用 fast.ai 打底,再回来补第 5 到 8 章。站内那篇CS50x 学习路线讲的是同类问题:课程大纲怎么拆成周计划,这套方法换到这边同样能用。
常见卡点:显存、版本漂移与提问方式
- 显存。第 3 章微调 BERT 类模型,Colab 免费档的 T4 够用;第 11、12 章动到大模型,全参微调放不下,得靠 LoRA、量化或换更小的底座。显存不够时先降 batch size 与序列长度,再考虑换卡。
- 版本漂移。课程随 transformers、datasets、trl 迭代,半年前的 notebook 里可能已有改名的参数。报错先对照章节页面上的当前代码,别照抄博客里的旧片段。
- 环境。Windows 不被官方覆盖,本地装 CUDA 与驱动是高频故障点。先在 Colab 跑通,再往本地搬,能省掉一半排障时间。
- 提问。第 8 章专门讲这件事:给出完整报错、库版本、复现步骤,比贴一句「跑不起来」有效得多。论坛在 discuss.huggingface.co。
课程内容在 huggingface/course 仓库里维护,更新不算慢,第 12 章还标着新上线。这也意味着笔记类资料容易过期,遇到前后矛盾时,以仓库里的目录与章节页为准,别以二手教程为准。
适合的人:会 Python、想尽快把开源模型用起来、能接受「先跑通再理解」的节奏。不适合的人:想要系统推导、准备考试、或者完全没有编程经验。真要上手,建议先做三件事:开一个 Hugging Face 账号,用 Colab 跑完开篇部分的安装单元,再挑第 2 章的一节不看答案自己写一遍。跑得动再谈进度,跑不动就先补 Python。站内Kaggle Learn 微课程那种短单元适合补基础语法,本地跑大模型选哪个引擎可以留到第 11 章之后再读,那时对量化与显存才有体感。
相关地址
以下为课程与配套仓库的官方入口,章节顺序、依赖与作业以这些页面为准。
- LLM Course 课程主页:https://huggingface.co/learn/llm-course
- 课程开篇与前置要求:https://huggingface.co/learn/llm-course/chapter1/1
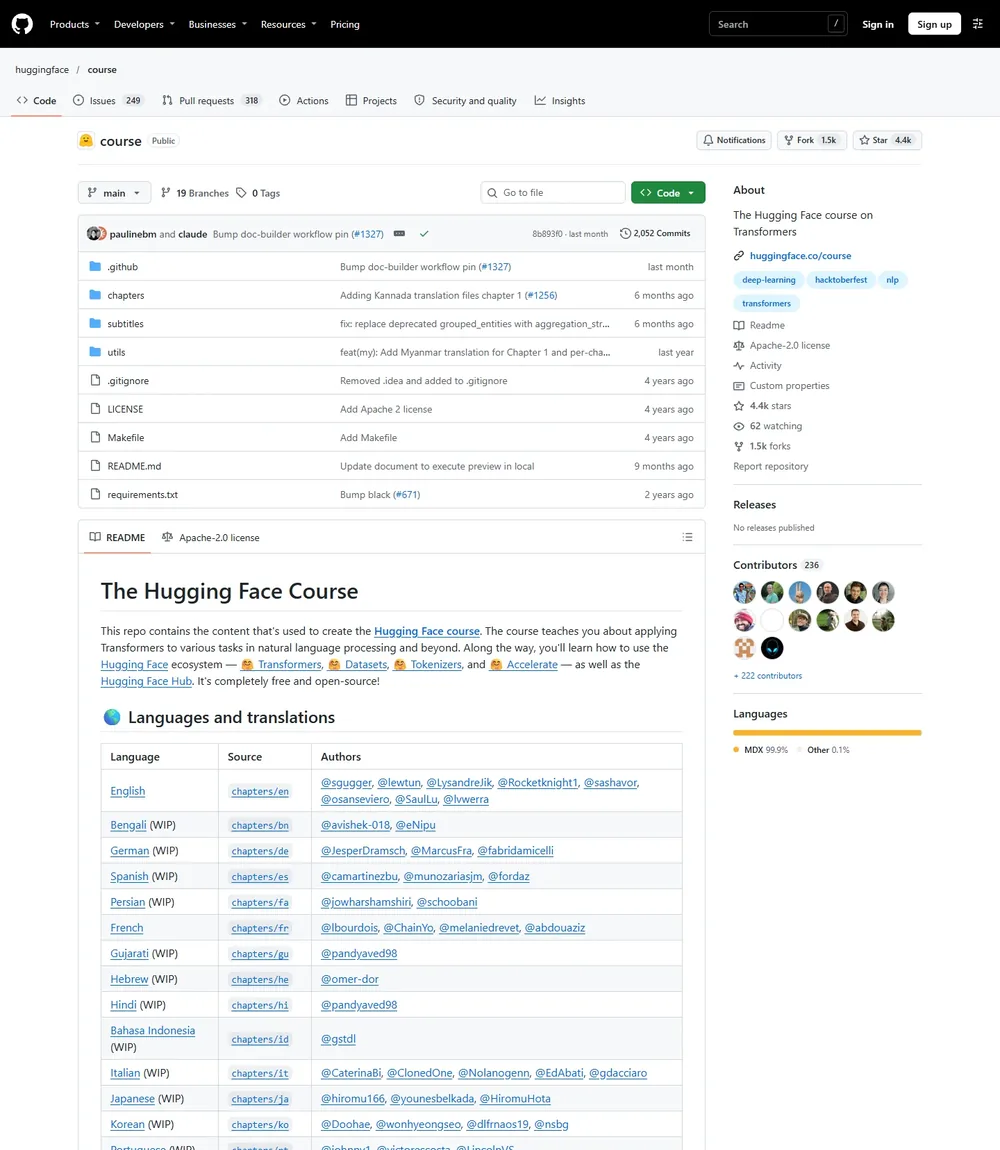
- 课程内容与章节目录仓库:https://github.com/huggingface/course
- 配套 Notebook 仓库:https://github.com/huggingface/notebooks
- Hugging Face 课程总入口:https://huggingface.co/learn
- fast.ai 实践课:https://course.fast.ai/
- Stanford CS224N:https://web.stanford.edu/class/cs224n/
© 版权声明
文章版权归作者所有,转载需注明出处。未声明原创的皆为网络收集,如有侵权请邮箱lishiwenhuagx@sina.com联系下架处理。
相关文章