
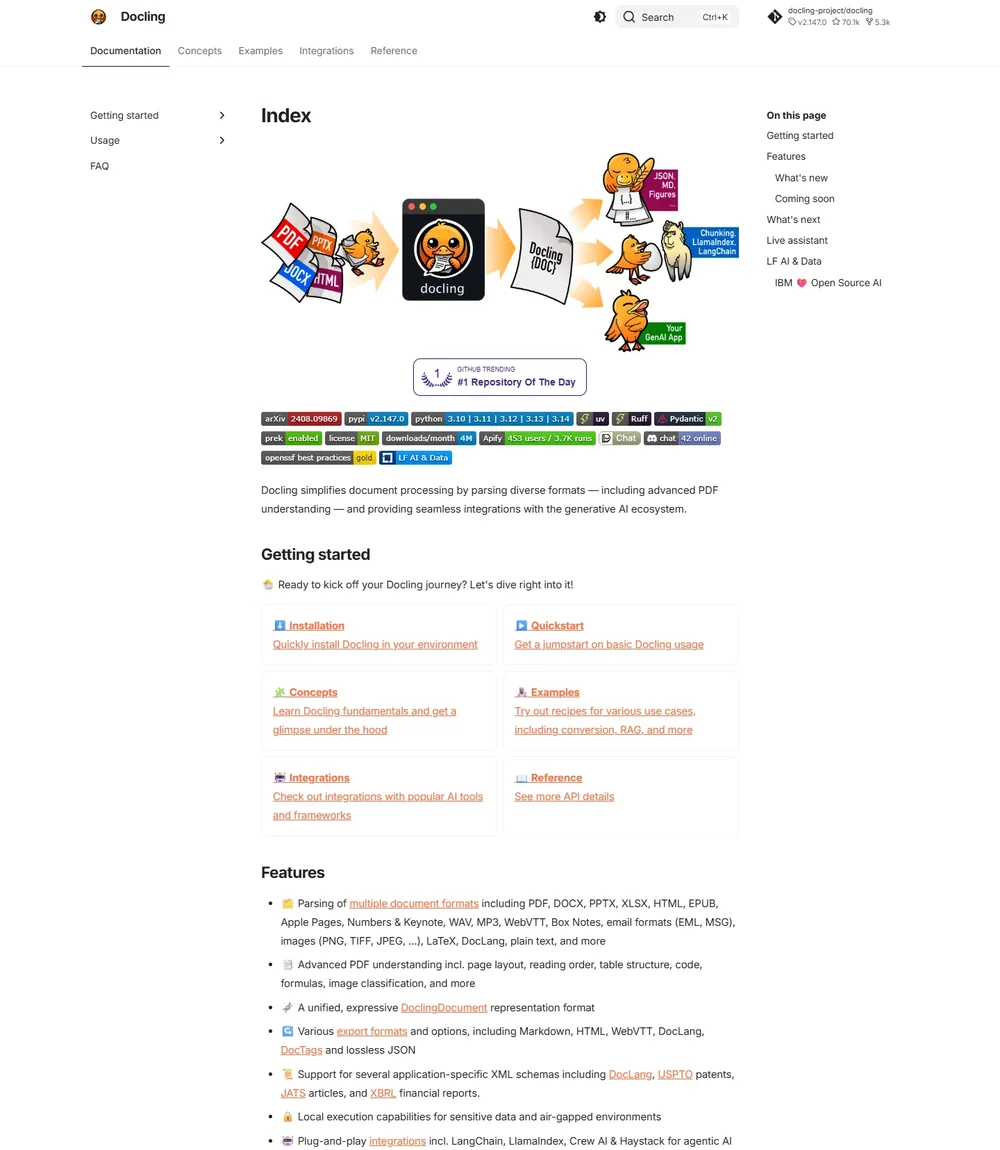
Docling 是一个开源文档解析工具,最初由 IBM 苏黎世研究院的团队做出来,现由 LF AI & Data 基金会托管。它把 PDF、Office 文件、图片和音频转成带版面信息的 Markdown 或 JSON,专门处理双栏串行、表格塌成一行字、扫描件没有文本层这三类老问题。上手成本不高,但边界要提前看清。
它解决的是解析这一步
代码放在 GitHub 的 docling-project 组织 下,采用 MIT 许可证,2026 年 11 月 3 日发布的版本是 2.146.0。维护节奏很密,最近几个月几乎每周都有小版本,修的多是表格、邮件、Office 格式这类边角问题。
做检索增强生成时,多数教程从分块讲起,把解析当成一行代码。可上游一旦读错,后面再好的嵌入模型也只能在错位的文本里检索。
普通提取器按字符流输出:双栏会左右串行,表格只剩一排数字,页眉页脚插进段落中间。Docling 的做法是先判断每页有哪些区域、区域属于标题还是正文,再按人眼顺序重排。
重排之后,内容落到统一的 DoclingDocument 结构里,页码、元素类型和坐标都能保留下来。
- 版面与阅读顺序:双栏、多栏、图文混排按人的读法排序,不按 PDF 内部的绘制顺序。
- 表格结构:还原行列与多级表头,而不是用空格把单元格拼回去。
- 公式与代码:公式转成 LaTeX,代码块识别出语言。
- 扫描件:页面没有文本层时交给 OCR。
- 图表:柱状图、饼图、折线图可以转成表格或附一段描述。
这些能力合起来,等于把“这份文件长什么样”也一起交给下游,而不只是“里面有哪些字”。输入侧覆盖 PDF、DOCX、PPTX、XLSX、HTML、EPUB、邮件、图片和音频,输出侧统一成一种文档模型。
安装与转换:一条命令先跑通
环境要求不复杂:Python 3.10 或更高,执行 pip install docling 即可。macOS、Linux、Windows 都有对应安装包。安装时会带入 PyTorch 等依赖,磁盘占用不小,空间紧张的机器建议先看剩余容量。完整的可选依赖清单在安装文档里,OCR 引擎和音频支持都是按需追加的。
命令行用法很直接:docling report.pdf --to md --to json。要批量处理一个目录,写 docling ./corpus --to md --output ./out,结果会按文件名落在指定目录。
Python 里则是三步:构造 DocumentConverter,调用 convert,从返回对象里导出 Markdown。source 既可以是本地路径,也可以是 URL,抓取远程 PDF 不必先手动下载。
模型权重在初次运行时下载并缓存,之后可以断网执行。这一点对处理合同、财报这类不方便外发的文件很关键,也是它和云端解析服务的主要差别,项目主页把“本机运行、无需账号”写在了显眼位置。
三种输出怎么选:Markdown、JSON 与 DocTags
同一份文档能导出成几种形态,选哪种取决于下一步给谁用。
| 输出 | 适合的场景 | 需要注意 |
|---|---|---|
| Markdown | 人工抽查、拼进提示词、轻量知识库 | 复杂合并单元格仍可能被简化 |
| 无损 JSON | 需要页码、坐标、元素类型做溯源 | 体积大,要自己写遍历代码 |
| HTML 与 DocTags | 保留标签结构,做二次渲染或版本比对 | 周边工具和示例相对少 |
Markdown 适合先跑通,JSON 适合做产品。稳妥的顺序是:先用 Markdown 看阅读顺序对不对,再决定是否为了页码和坐标切到 JSON。
如果只是评估解析质量,Markdown 里的标题层级和表格结构已经能暴露大部分问题,不必一上来就写解析器。
表格与扫描件:两个容易出错的环节
表格是最容易被高估的部分。Docling 用单独的结构模型判断表头、行、列和合并关系,输出真正的表格,而不是用空格对齐的文本。但跨页表、无边框表、单元格里再套列表,仍然需要人工抽查。
扫描件则要先看有没有文本层。带文本层的 PDF 直接解析更快,强行开 OCR 只是浪费时间;纯图片页才需要 OCR 兜底。
安装包默认带 RapidOCR,够用且不挑平台。要换引擎可以装 easyocr、tesserocr 等附加依赖,语言用 BCP-47 标签指定。Tesseract 还需要系统里先装好程序和对应语言包,否则会退回无 OCR 模式。
版面特别花的文件,可以切到视觉语言模型管线,用 granite_docling 这类模型整页理解。代价是显存和速度,适合少量难页,不适合整库批跑。
接进 RAG:分块、服务化与 MCP
解析完只是拿到干净结构,离可检索还差分块。Docling 自带 HybridChunker:先按标题层级切,再用 tokenizer 对齐你实际使用的嵌入模型,超长的块才拆,过短的相邻块合并。
表格跨块时它默认重复表头,后面的块不会只剩一堆没有列名的数字。这个细节在财报和实验报告上很实用,也是很多自写脚本容易漏掉的地方。
团队共用可以起 docling-serve,镜像和端口都是现成的:docker run -p 5001:5001 quay.io/docling-project/docling-serve。对外是 HTTP 接口,前端和后端调用同一套解析逻辑,不必各自装一份模型。
智能体侧有现成 MCP 服务,uvx --from docling-mcp docling-mcp-server 就能挂上去,让 Agent 直接读文档,而不是读一堆乱码。
它在流水线里的位置,和 Crawl4AI 把网页转成 Markdown 的位置类似:一个管网页,一个管文件。解析结果要建索引,可以接着看 HNSW 向量索引 的原理;如果目标是把纸质档案归档后检索,Paperless-ngx 的 OCR 归档 那条路更省事。
边界、适用人群与上手顺序
先说清楚它不是什么:Docling 不提供问答界面,也不做向量库。它交付的是结构化文档,后面的分块、嵌入、检索、重排都要自己接。
许可证是 MIT,代码可以商用;但随包下载的版面、表格、OCR 模型各有各的条款,上线前要逐个核对。这一点在第三方评测里也被单独提醒过。
IBM 另有一个托管版本,官方页面按 4 美元每千页计费,省掉部署和运维;自建则是没有授权费,自己承担机器和时间。两条路的取舍很直接:文档量小、偶发处理,托管更省心;量大且不能出内网,自建更合适。
还有一点容易被忽略:解析质量的上限取决于原文件。同一份报告,电子版 PDF 和打印后扫描的版本,输出差别可能很大。先把最容易出错的那批文件挑出来试,比全量跑一遍再回头排查更划算。
适合的人:要做企业内部知识库的团队;手里有大量合同、研报、标准文档需要结构化;对数据外发有顾虑、必须本地处理的场景。
不太适合:只想把一篇文章粘给模型看的个人;习惯在手机上处理文件;以及期待装完就能问答的人。
常见问题
需要 GPU 吗? 不强制。CPU 能跑,带表格和图片的复杂 PDF 按页计算时间;批量处理扫描件时,GPU 或专门的解析服务更现实。
中文扫描件能识别吗? 取决于 OCR 引擎和语言包。选支持中文的引擎并指定语言标签,再用自己的样本抽查,不要直接信默认值。
和 PyMuPDF、pdfplumber 有什么区别? 后两者偏向取文本和坐标,规则由你写;Docling 多了版面模型、阅读顺序和表格结构,代价是更重、更慢。
准备试的话,先挑 20 份文件:5 份双栏、5 份带合并单元格的表格、5 份扫描件、5 份普通文档。跑完 Markdown 逐份看阅读顺序和表头,再决定要不要上 JSON 和服务化。
© 版权声明
文章版权归作者所有,转载需注明出处。未声明原创的皆为网络收集,如有侵权请邮箱lishiwenhuagx@sina.com联系下架处理。
相关文章


